Scrapling:把 HTTP、隐身浏览器、解析与 MCP 收进一套 Python 爬虫框架
摘要
Scrapling 是 BSD-3-Clause 的 Python 网页抓取框架:快速 HTTP、隐身浏览器、并发 Spider、暂停续跑与 MCP Server/Agent Skill 一体;约 9 万星,支持 Python 3.10+,适合开发者与 AI Agent 合法采集场景。
本文目录
做现代网页采集时,静态页要快、动态页要能渲染、长任务要能暂停续跑,AI Agent有时还得直接上手浏览器——工具链往往要拼 Fetcher、Playwright、解析库和自写调度。Scrapling(GitHub:`D4Vinci/Scrapling`)是一个 BSD-3-Clause的 Python网页抓取框架:把快速 HTTP、隐身无头浏览器、强大解析与并发爬虫放进同一库,并提供 CLI、交互式 Shell、以及给 AI Agent用的 MCP Server 与 Agent Skill。本文整理时仓库公开星标约 90866、fork约 9467(以 GitHub实时数为准);支持 Python ≥3.10(含3.10–3.13);PyPI近月下载约 92万次,Docker镜像拉取约 9.4万次(分别来自 pypistats / Docker Hub公开接口)。
官方定位是「Effortless Web Scraping for the Modern Web」:从抽几个字段到把整站收成干净 Markdown,都可以在 Python、终端或 AI Agent里走通。文档与中文 README同步维护于 Read the Docs。
图片来源:官方仓库 docs/assets/cover_dark.png
它解决什么问题
真实站点很少再是「纯静态 HTML + 固定选择器」:有的要 JS渲染,有的要会话与代理轮换,有的要在被限流时自动降速,长爬还要 Ctrl+C后还能从检查点续跑。另一边,编码 Agent与对话式助手越来越常被要求「打开网页、截图、抽数据」,却又缺少一套有会话、可隐身、能降噪的浏览器工具链。Scrapling把 Fetcher / StealthyFetcher、Spider调度、解析导航、导出、MCP 收在同一项目里,减少「多库拼装 + 自己写暂停续跑」的摩擦;同时提供开发模式(首次把响应缓存到磁盘、后续重放)方便迭代 `parse()`,以及可选的 robots.txt遵守与广告域拦截等工程细节。
文中示例站点以官方文档常用的公开演示页(如 quotes.toscrape.com)为准;请只在合法授权范围内采集,并遵守目标站条款与当地法律——本文只做开源发现介绍,不提供绕过受保护站点或未授权访问的操作指南。
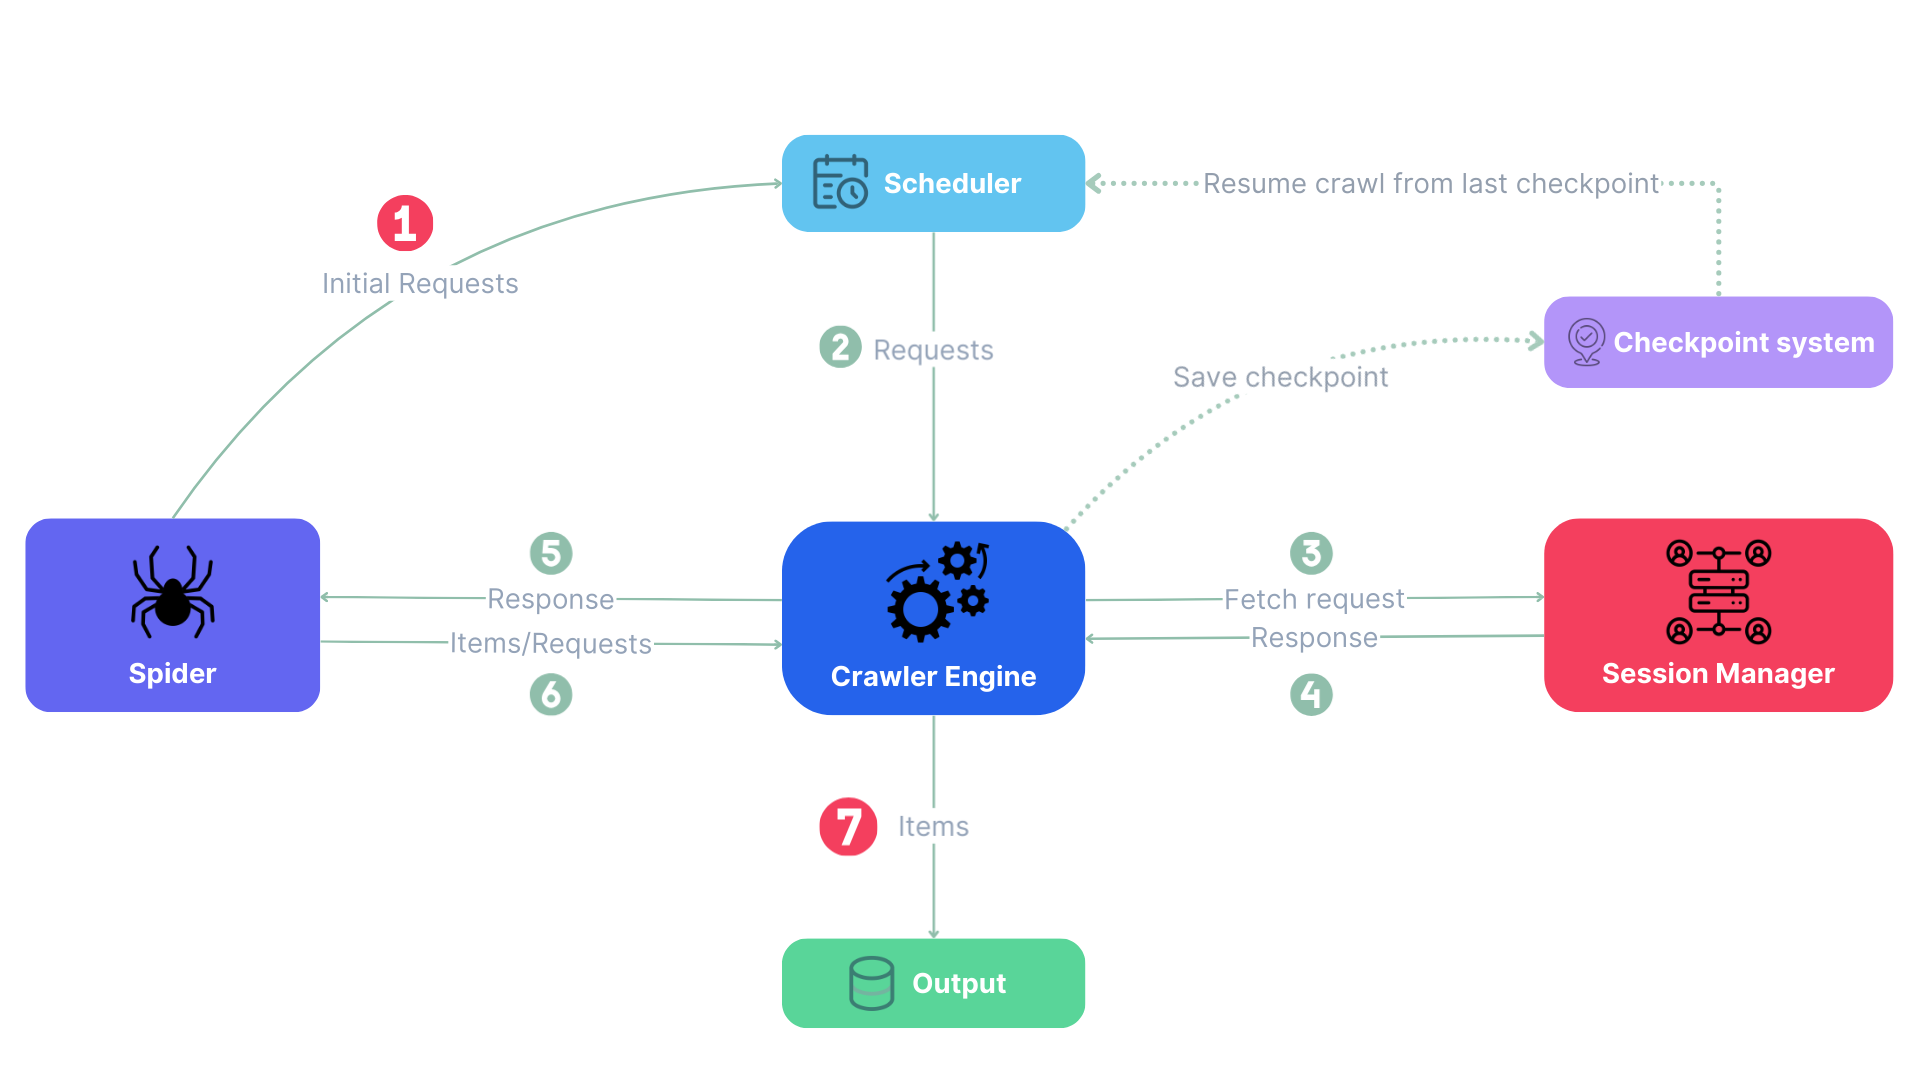
图片来源:官方仓库 docs/assets/spider_architecture.png
它能做什么
- 获取与交互:`Fetcher` 做快速 HTTP(可模拟浏览器 TLS/请求头,支持 HTTP/3);`StealthyFetcher` 基于 Playwright Chromium/Chrome做动态加载与隐身能力;持久会话(`FetcherSession` / `StealthySession`)、代理轮换、域名/广告拦截、可选 DoH,以及通过 CDP连接远程浏览器。
- 解析与提取:CSS、XPath、类 BeautifulSoup风格查找、文本/正则搜索;元素相似度跟踪与 `find_similar`;一键 `page.markdown()` 产出面向 LLM的干净 Markdown。
- Spider爬取框架:类 Scrapy的 `start_urls` + async `parse`;并发与 AutoThrottle;多会话按 ID路由;`crawldir` 暂停/恢复;`stream()` 流式出结果;内置 JSON/JSONL/CSV/XML导出;模板含 CrawlSpider、SitemapSpider、XML/CSV Feed、ShopifySpider、ContentSpider等。
- AI与终端:MCP Server供 Claude/Cursor等 Agent浏览、截图、抽数(含会话与后台 API捕获相关能力);可安装的 Agent Skill约束生成代码贴近当前 API;CLI与交互式 IPython Shell(含 curl转 Scrapling请求等辅助)。
- 工程与分发:测试覆盖率官方宣称约92%、完整类型标注;PyPI包名 `scrapling`,当前 PyPI版本约 0.5;Docker镜像 `pyd4vinci/scrapling`;中英文及多语言 README/文档。
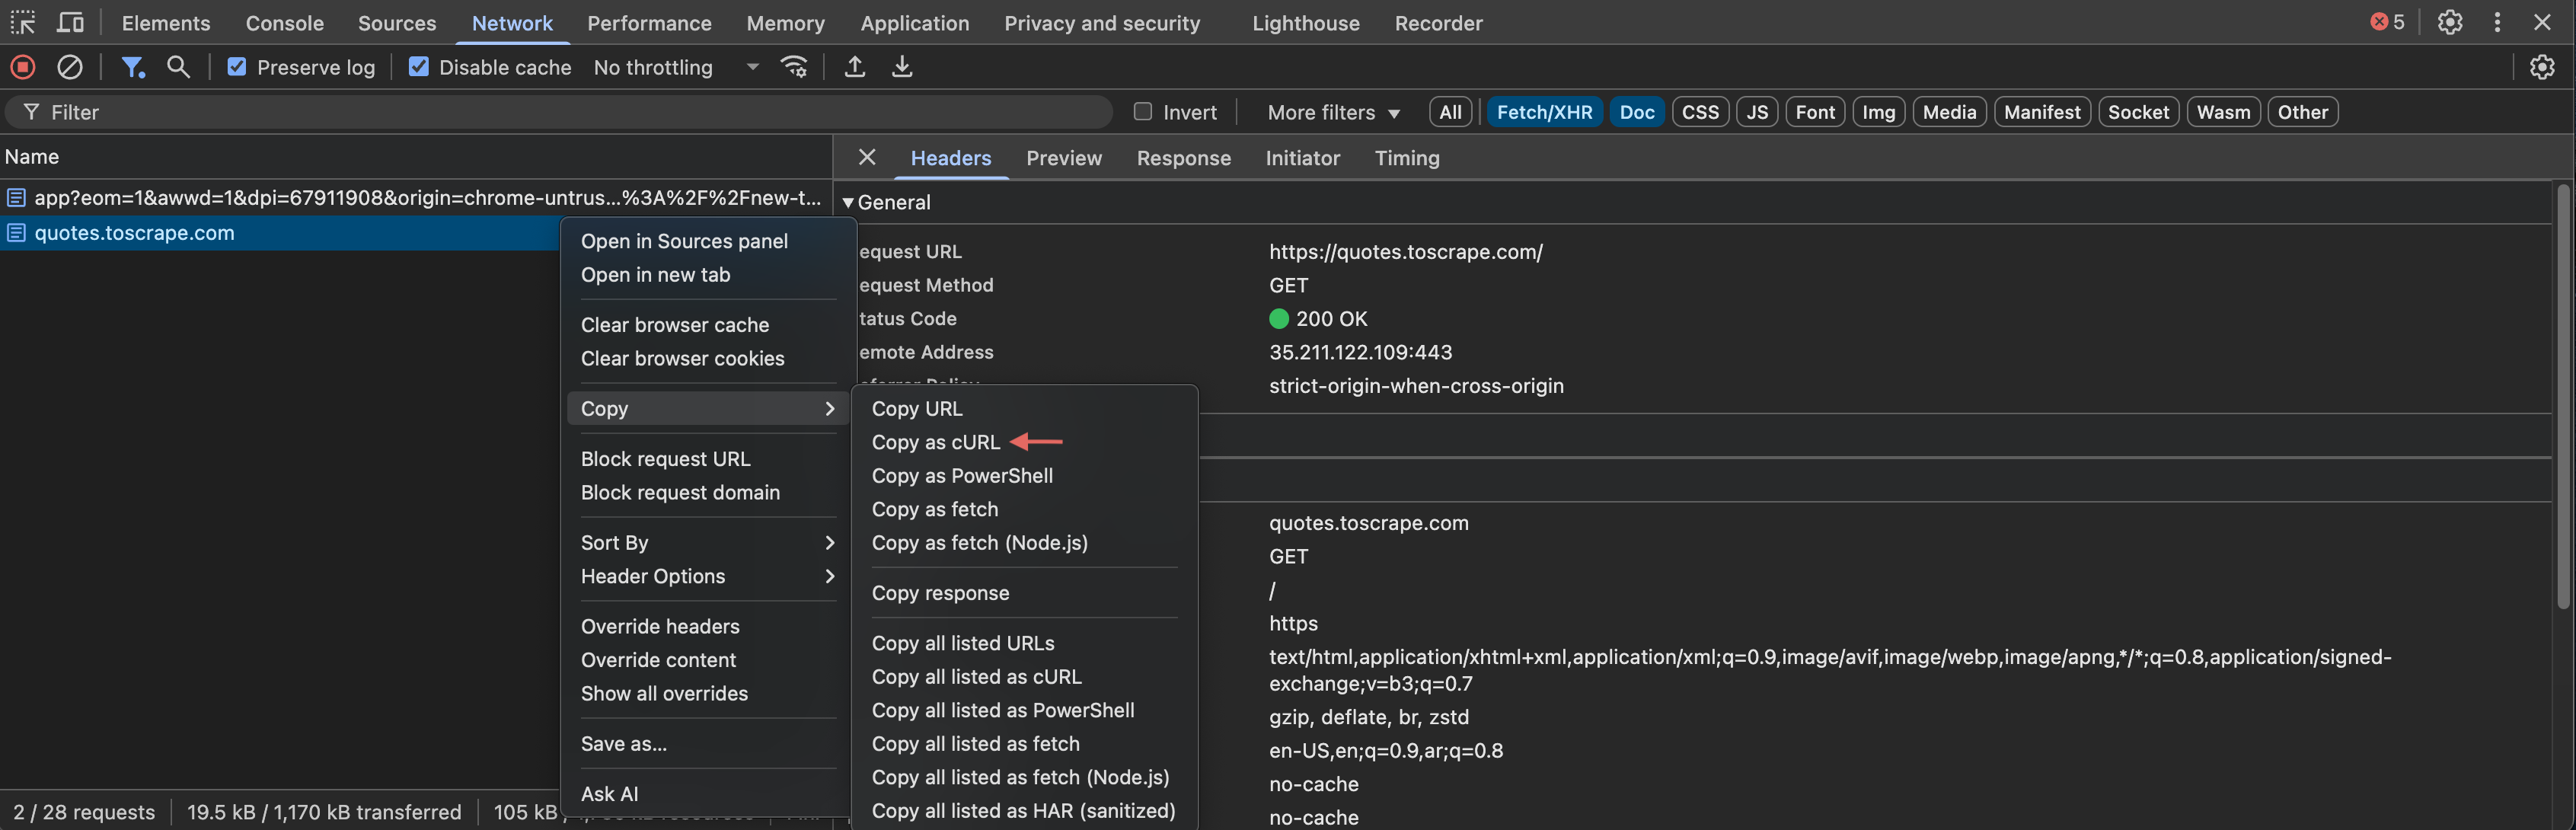
图片来源:官方仓库 docs/assets/scrapling_shell_curl.png
有什么好处
一条链路覆盖静态与动态:不必为「快请求」和「真浏览器」各维护一套会话与导出逻辑;同一 Spider里可把普通页走 HTTP会话、受保护页走隐身会话。
长任务可中断可续跑:`crawldir` 保存待请求与已见 URL,适合过夜爬或需要人为停顿的场景;开发模式缓存响应,改解析逻辑时少打目标站。
对 AI Agent友好:MCP + Agent Skill + Markdown/ContentSpider,让「让模型写爬虫」和「让模型直接抓」两条路都有官方落点,而不是临时拼浏览器插件。
许可与生态清楚:BSD-3-Clause;topics覆盖 mcp、playwright、stealth、web-scraping;社区有 Discord与文档站。功能边界以仓库 README与 [官方文档](https://scrapling.readthedocs.io/en/latest/) 为准,版本升级时请对照 changelog。
图片来源:官方仓库 docs/assets/logo.png
适合谁
适合需要 Python统一采集栈(HTTP + 无头浏览器 + 并发 Spider)的数据/后端开发者;适合想给编码 Agent接 MCP浏览与抽取、或用 Agent Skill约束生成 Scrapling代码的人;也适合从终端/Shell快速试选择器、把 curl转成可维护请求脚本的爬虫工程师。
若你的目标只是极简单页 requests、或必须严格复用现有 Scrapy中间件生态,请先对照文档里的 Fetcher/Spider选型说明。权威来源:https://github.com/D4Vinci/Scrapling ;文档:https://scrapling.readthedocs.io/en/latest/ 。本文只做开源发现介绍,不替代官方 README、许可证与合规要求。