谷歌发布 Gemini 3.8 语音生成模型:可定制角色声音、逐句导演双人对话
摘要
谷歌推出 Gemini 3.8 Flash TTS 与 Flash Lite TTS 两款文本转语音模型,支持自然语言设计角色声音、逐句控制情绪和双人对话,并提供声音复现、长篇生成及批量配音能力。本文梳理两款模型的定位、开放渠道、使用限制与声音授权保护措施。
本文目录
谷歌于2026年9月23日介绍了两款新的文本转语音模型:Gemini 3.8 Flash TTS和 Gemini 3.8 Flash-Lite TTS。它们能将文字脚本转换成带有语气、情绪和角色特征的语音,让创作者不仅能选一个声音朗读文字,还能控制人物怎么说话、如何接话,以及长篇内容中声音是否保持一致。两款模型分别面向精细的声音创作和需要大量生成语音的业务场景。
两款模型分别解决什么问题
Gemini 3.8 Flash TTS偏向创作控制。用户可以用自然语言描述角色、口音、音色和说话方式,设计新的声音,并对每句台词设置表演要求。游戏角色、广播剧、有声书和播客等需要不同人物声音的内容,可以在同一制作流程里完成角色设计和台词生成。
Gemini 3.8 Flash-Lite TTS则面向高吞吐量、成本敏感的任务,例如批量配音、音频内容制作以及语音智能体。谷歌表示,它在强调生成效率的同时,仍支持语气、语速和表达细节控制。两款模型的定位不同,具体选型仍需结合生成量、延迟、成本和声音表现进行测试。
从描述声音到逐句控制台词
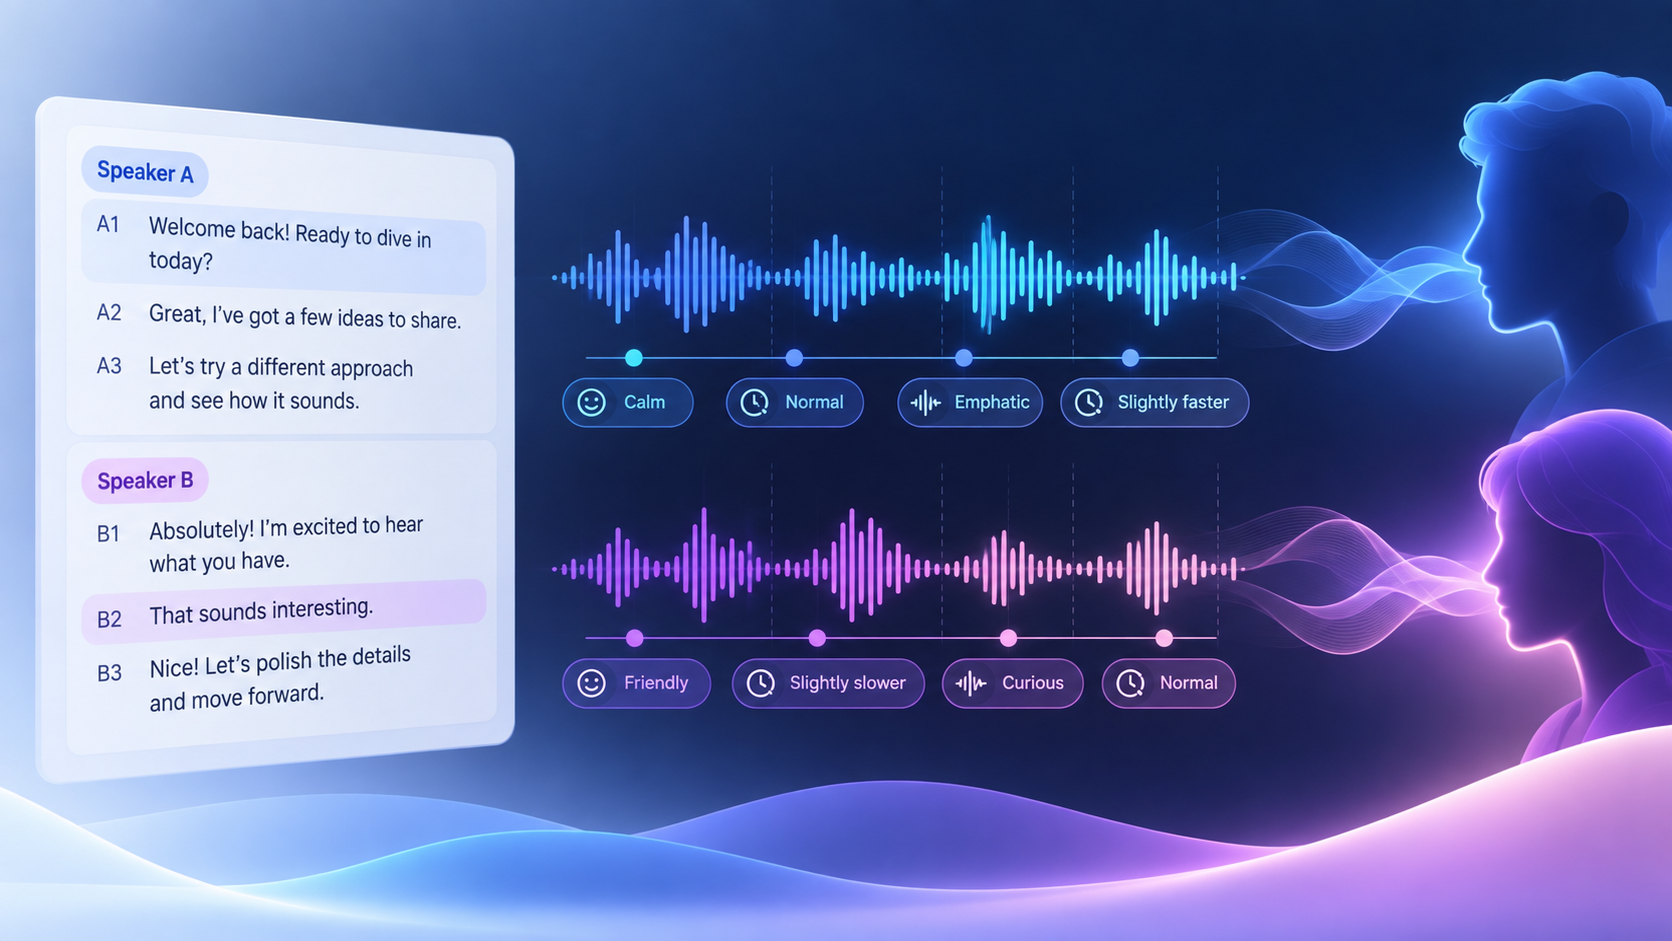
使用 Gemini 3.8 Flash TTS,创作者可以通过文字提示设计角色声音,包括地域口音和人物特征。谷歌介绍称,新模型支持超过100种语言及方言,并提供超过2,000个可用于制作的声音选项。设计好的自定义声音还可以保存和管理,便于连续制作时维持角色声音的一致性。
对于已有声音,模型还支持根据约30秒的音频样本复现声线,但仅限本人或已取得使用权的声音,并需通过声音所有者的口头同意验证。谷歌还预告了声音 Remix功能,未来可在现有声音基础上调整音色、音高、语速和口音;这一功能属于即将推出的能力,不应与当前已开放功能混淆。
在台词生成环节,两款模型均支持逐句控制表达方式。创作者可以标注情绪、节奏与停顿,安排双人对话中两位说话者的轮流发言,并加入笑声、叹气或表示倾听的简短回应。谷歌还强调长篇语音生成的声音稳定性,目标是在播客、有声书等连续内容中减少角色音色漂移。
开放渠道及适用范围
谷歌宣布,两款模型从发布日起陆续通过 Gemini API和 Google AI Studio向开发者开放。Google AI Studio新增面向声音设计的交互工作区,用户可设计新声线、体验获授权的声音复现,并在双人脚本编辑器中调整每句台词。面向普通用户,Gemini 3.8 Flash TTS将用于 Gemini Notebook,Flash-Lite TTS将用于 Google Vids;企业侧通过 Gemini Enterprise API提供的能力则为后续开放。
在业务应用方面,谷歌提到与 Figma、HeyGen、Linguana、Wondercraft等公司的合作,应用方向包括多语言配音、地域化语音和对话式语音智能体。可用功能和地区仍须以各产品实际开放情况为准。谷歌特别注明,Google AI Studio中的声音复现功能目前不在美国伊利诺伊州、得克萨斯州、欧洲经济区、英国、瑞士及印度提供。
声音复现与生成内容标识
高度逼真的语音生成也带来冒用他人声音的风险。谷歌表示,声音复现要求提供与参考说话人匹配的口头同意录音;Gemini Audio生成的音频还嵌入 SynthID水印,并配合 C2PA内容凭证等机制帮助标识生成内容。这些措施是平台提供的防护手段,并不意味着任何传播场景下都能自动阻止音频被误用。
对音频制作团队而言,这次更新的直接变化是把声线设计、台词表演控制和批量语音生成放进同一模型系列。需要制作高表现力角色对白的团队可关注 Flash TTS;以大量配音和语音接口为主的团队则可测试 Flash-Lite TTS的实际质量、延迟与费用,再决定如何接入现有流程。