Karpathy 的 GitHub 等于一门免费 AI 学位:7 个仓库从反向传播练到自动研究智能体
摘要
Andrej Karpathy(github.com/karpathy)7 个仓库串成免费 AI 学习路径:micrograd → nn-zero-to-hero → minbpe → nanoGPT → llm.c → nanochat → autoresearch;从反向传播到自动研究智能体。写作时七仓合计约 309024 星,多数 MIT。
本文目录
Andrej Karpathy(GitHub:`karpathy`)把「从零理解神经网络 → 自己训出 GPT → 再让 Agent自动做研究」拆成了一条可动手的开源路径。社区近期有视频按学习顺序串起他的7个仓库,口径很直白:Karpathy的 GitHub差不多等于一门免费 AI学位——不卖课、不藏实现,代码本身就是教材。本文按这条顺序介绍,星标与 fork取自 GitHub实时公开数据(写作时七仓合计约 309024 星;数字会变,以仓库页为准)。作者主页:https://github.com/karpathy 。
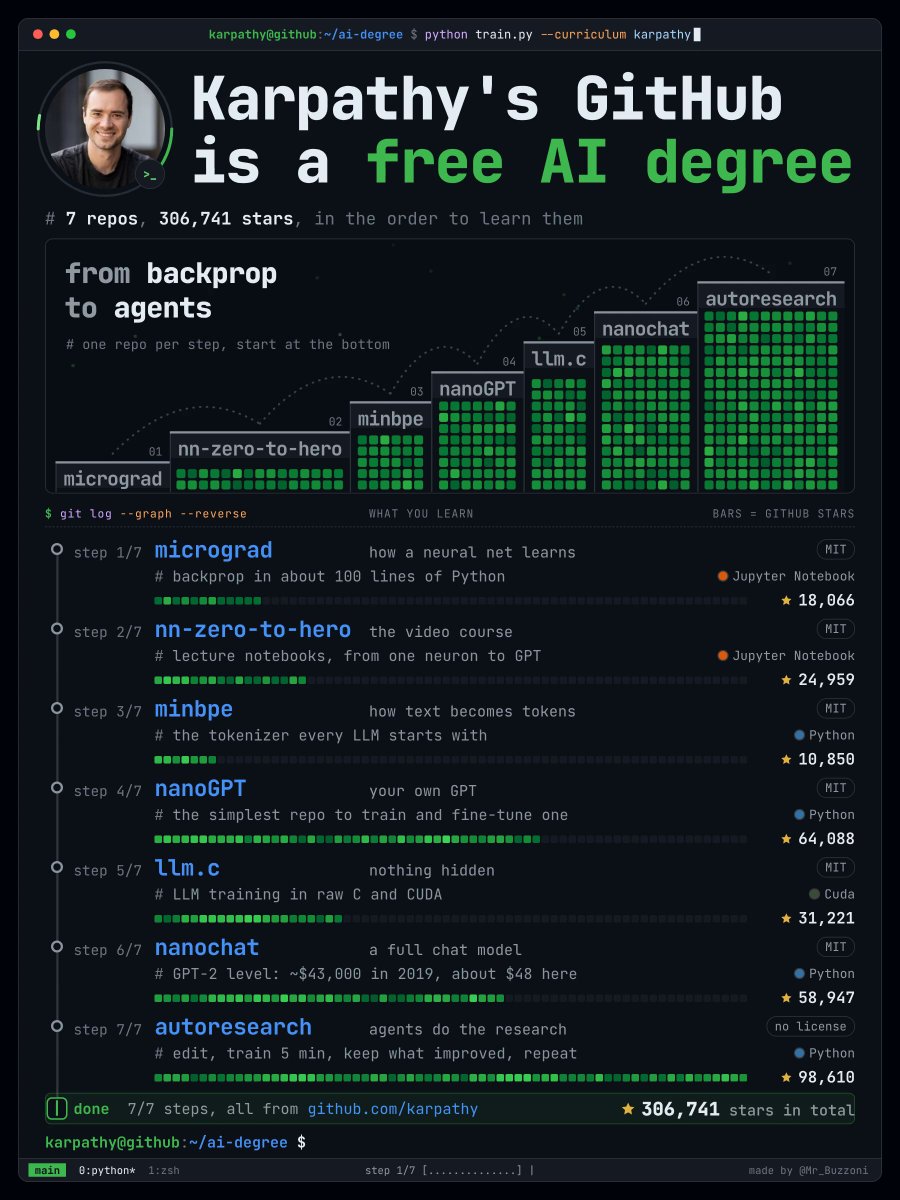
图片来源:X amplify_video_thumb(帖 2116475548549669005 相关视频预览)
它解决什么问题
网上 LLM教程很多,但常见断点是:要么停在公式与幻灯片,要么一上来就调黑盒 API;想「亲手写出反向传播、Tokenizer、训练循环,再摸到系统层与研究 Agent」,材料往往散落在不同课程与博客里。Karpathy这批仓库把同一作者、同一风格(短、可读、可跑)的代码按能力递进排成路径:先懂梯度如何流动,再看完整视频课与笔记本,再啃分词与 GPT训练,再下沉到 C/CUDA,最后到可聊天的小模型与自动研究循环。
对自学与工程入门的人来说,价值不在「又一个 awesome列表」,而在可复现的脚手架:每个仓库都能 clone后跟着改;视频课(nn-zero-to-hero)与代码仓库互相指认,减少「看懂了却写不出来」。下面按推荐学习顺序展开;描述以各仓库 README为准。
图片来源:GitHub avatar for karpathy
七仓学习路径(推荐顺序)
1. micrograd — 神经网络如何学习
- 仓库:https://github.com/karpathy/micrograd
- 实时数据:约 18573 星/2955 fork;协议 MIT
- 官方描述:A tiny scalar-valued autograd engine and a neural net library on top of it with PyTorch-like API
用约百行级 Python搭出标量自动微分与小型神经网络:前向、反向、更新一步步看得见。适合把「反向传播」从黑话变成可调试的代码直觉。
2. nn-zero-to-hero — 视频课与笔记本
- 仓库:https://github.com/karpathy/nn-zero-to-hero
- 实时数据:约 25198 星/3671 fork;协议 MIT
- 官方描述:Neural Networks: Zero to Hero
配套视频课程与 lecture notebooks,从 micrograd一路讲到 GPT。适合当作「主线课表」:看一讲、跑一讲笔记本,再回对应仓库深挖实现。
3. minbpe — 文本如何变成 token
- 仓库:https://github.com/karpathy/minbpe
- 实时数据:约 10981 星/1147 fork;协议 MIT
- 官方描述:Minimal, clean code for the Byte Pair Encoding (BPE) algorithm commonly used in LLM tokenization.
几乎所有现代 LLM的第一步都是 Tokenizer。minbpe把 BPE写得极简干净,方便理解词表如何从字节对合并长出来,而不是只调用现成 `tiktoken`。
4. nanoGPT — 自己训一台 GPT
- 仓库:https://github.com/karpathy/nanoGPT
- 实时数据:约 64349 星/11060 fork;协议 MIT
- 官方描述:The simplest, fastest repository for training/finetuning medium-sized GPTs.
社区口中「最简单、够快」的中等规模 GPT训练/微调脚手架。想搞清楚数据加载、训练循环、checkpoint与微调入口,从这里下手成本最低。
图片来源:GitHub Open Graph for karpathy/nanoGPT
5. llm.c — 用原始 C/CUDA训 LLM
- 仓库:https://github.com/karpathy/llm.c
- 实时数据:约 31363 星/3806 fork;协议 MIT
- 官方描述:LLM training in simple, raw C/CUDA
把训练链路沉到「几乎没有框架封装」的 C与 CUDA:性能与内存布局更透明,适合已经能跑通 nanoGPT、想知道「框架底下到底在干什么」的人。
6. nanochat — 一百美元级的完整聊天模型
- 仓库:https://github.com/karpathy/nanochat
- 实时数据:约 59527 星/8378 fork;协议 MIT
- 官方描述(以 README/仓库页为准):The best ChatGPT that $100 can buy.
从「能训 GPT」迈到「能聊起来」的全栈小聊天模型路径。仓库自我定位很醒目:在约百美元量级预算里,把聊天模型相关环节尽量跑通;细节与硬件假设请以官方 README为准。
图片来源:GitHub Open Graph for karpathy/nanochat
7. autoresearch — 前沿上的研究智能体
- 仓库:https://github.com/karpathy/autoresearch
- 实时数据:约 99033 星/13670 fork;仓库页当前未标注 SPDX license(以 GitHub为准)
- 官方描述:AI agents running research on single-GPU nanochat training automatically
路径终点:让 Agent在单卡 nanochat训练上自动做研究——改代码、短训几分钟、留下变好的改动、再循环。社区视频里常概括为「编辑 → 训约5分钟 → 保留改进 → 重复」。这是从「学会训练」到「用 Agent加速实验」的桥。
图片来源:GitHub Open Graph for karpathy/autoresearch
有什么好处
- 一条作者一致的能力阶梯:同一人、同一代码品味,从标量梯度到聊天模型再到研究 Agent,认知负担比东拼西凑十个教程低。
- 实现可读、可改:micrograd/minbpe/nanoGPT等刻意做「最小可运行」;llm.c则把黑盒打开到 C/CUDA。
- 课与码对齐:nn-zero-to-hero把视频与笔记本钉在路径中段,降低「只收藏不练」的概率。
- 接到当下热点:nanochat与 autoresearch把路径接到「可部署的小聊天模型」和「自动研究循环」,而不停在2022年的玩具 GPT。
- 几乎全 MIT:前六仓均为 MIT,便于学习、改写与二次分发;autoresearch请单独核对其 license状态。
图片来源:GitHub Open Graph for karpathy/micrograd
适合谁
- 想系统自学深度学习/LLM的工程师与学生:需要可动手仓库,而不是只看概念图。
- 已经会调 API、想补「训练与系统」直觉的应用开发者:从 nanoGPT/llm.c切入往往最解渴。
- 关注 Agent做科研/自动实验的人:可把 autoresearch当作单卡自动研究的参考实现,并回看前序仓库补齐训练基础。
若你只想快速调用云端大模型做产品、短期内不打算自己训或读内核,这条路径会偏「重」——可以先只看 micrograd + nn-zero-to-hero建立直觉。权威入口始终是各仓库与作者主页 https://github.com/karpathy ;星标、协议与 README以 GitHub实时页为准。本文只做开源发现介绍。相关讨论线索亦见于 X上对学习路径视频的转述帖,重点仍建议回到仓库本身动手。